Resumen ejecutivo
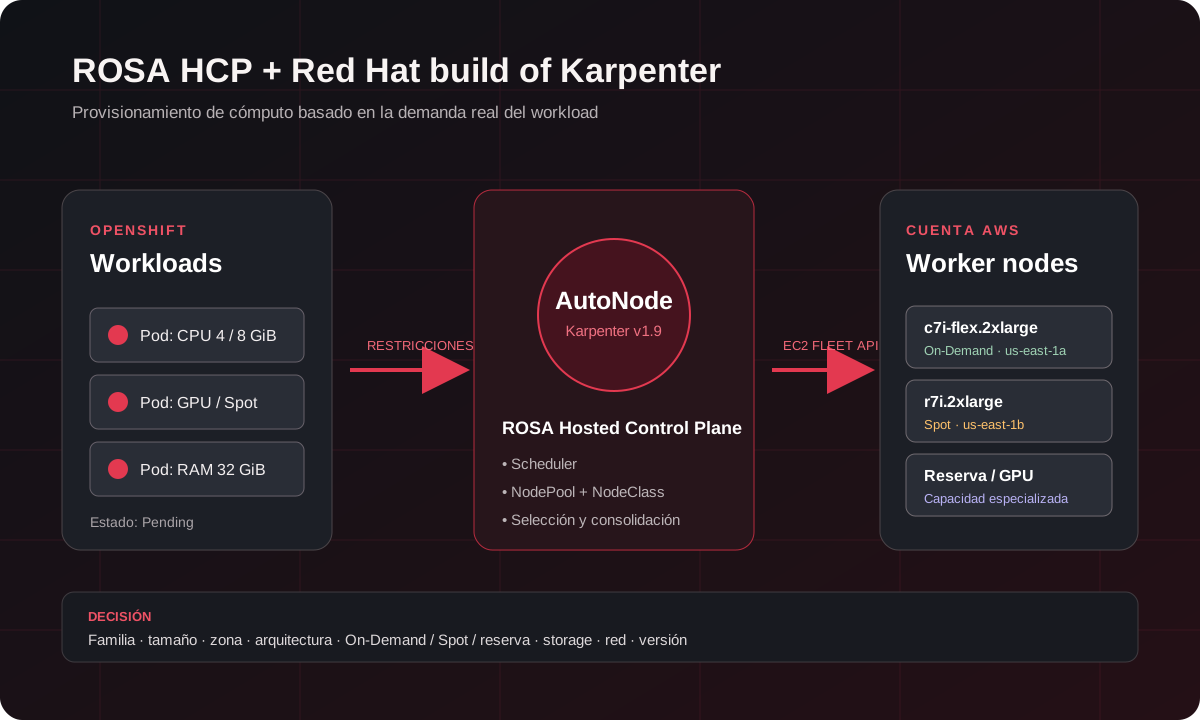
Red Hat OpenShift Service on AWS (ROSA) ofrece OpenShift administrado sobre AWS. En el modelo Hosted Control Planes (HCP), Red Hat opera el control plane en una cuenta de servicio y los worker nodes, redes y demás recursos de datos viven en la cuenta del cliente. Desde OpenShift 4.22, ROSA HCP puede habilitar Red Hat build of Karpenter, también llamado AutoNode.
Karpenter observa Pods que el scheduler no puede ubicar, reúne sus requisitos de CPU, memoria, arquitectura, zona, taints, afinidades y topología, y crea directamente instancias EC2 adecuadas. Cuando baja la demanda puede consolidar o eliminar nodos. La diferencia central frente al Cluster Autoscaler es que no necesita escoger primero un machine pool preconfigurado de un tipo fijo: decide capacidad a partir de la carga pendiente.
- Disponibilidad soportada: ROSA con Hosted Control Planes, OpenShift 4.22 o posterior y ROSA CLI 1.2.61 o posterior.
- Controlador administrado: se ejecuta dentro del hosted control plane; no se instala el chart upstream en los worker nodes.
- Unidad de configuración: un
NodePooldefine qué capacidad puede solicitar y unOpenshiftEC2NodeClassdefine cómo deben construirse los nodos. - Advertencia crítica: la configuración predeterminada admite Spot y los nodos expiran a los 30 días. Las cargas críticas deben fijar explícitamente
on-demandy contar con controles de disrupción. - Restricción de ROSA: los tipos seleccionados deben tener al menos 4 vCPU; no se admite capacidad estática mediante
spec.replicasen estos NodePools.
Estado del producto y alcance
Las notas vigentes de ROSA registran Red Hat build of Karpenter basada en Karpenter v1.9 dentro de las novedades de 2026. La presentación técnica de Red Hat delimita el alcance a ROSA con hosted control planes.
Eso tiene una consecuencia práctica: si el clúster es ROSA Classic, esta integración administrada no aplica. No conviene intentar convertir el servicio soportado en una instalación casera del controlador upstream. Para Classic se debe evaluar Cluster Autoscaler con machine pools, o migrar a HCP después de revisar compatibilidad, red, observabilidad, identidad y ventanas de cambio.
La responsabilidad también sigue siendo compartida. Red Hat opera la plataforma y el controlador; el cliente continúa siendo responsable de las aplicaciones, solicitudes y límites de recursos, reglas de scheduling, resiliencia, presupuestos de disrupción, cuotas, costos y datos. La matriz oficial de responsabilidades de ROSA es la referencia para delimitar cada capa.
El problema que resuelve
En un diseño tradicional se crean machine pools como general-m6i, memory-r6i, compute-c7i o gpu-g6. Cada pool tiene familia, tamaño, mínimo y máximo. El Cluster Autoscaler incrementa o reduce réplicas dentro de esos límites. Es estable y predecible, pero obliga a anticipar qué combinación de instancias necesitará cada carga.
Esta anticipación genera cuatro desperdicios frecuentes:
- Capacidad ociosa: mínimos altos para proteger el tiempo de respuesta ante picos.
- Forma equivocada: queda memoria libre en nodos CPU-heavy o CPU libre en nodos memory-heavy, aunque el total del clúster parezca suficiente.
- Demasiados pools: cada familia, arquitectura, GPU, zona o modalidad de compra termina como otro objeto operativo.
- Dependencia de una oferta EC2: un pool rígido no aprovecha fácilmente alternativas cuando un tipo o una zona no tiene capacidad.
Karpenter cambia la pregunta. En lugar de «¿cuántos nodos m6i.xlarge debe tener este pool?», resuelve «¿qué oferta EC2 compatible puede ejecutar ahora este conjunto de Pods pendientes al menor costo permitido por la política?».
HPA, Karpenter y Cluster Autoscaler no hacen lo mismo
| Capa | Observa | Acción | No resuelve |
|---|---|---|---|
| HPA / KEDA | Métricas de aplicación, CPU, memoria o eventos | Cambia el número de Pods | No crea capacidad EC2 por sí solo |
| Scheduler | Recursos y restricciones de cada Pod | Asigna un Pod a un nodo compatible | No crea nodos |
| Cluster Autoscaler | Pods pendientes y machine pools existentes | Aumenta o reduce un grupo predefinido | No elige libremente entre toda la oferta EC2 |
| Karpenter / AutoNode | Conjunto de Pods pendientes y ofertas EC2 | Crea un NodeClaim y una instancia adecuada | No corrige una aplicación mal dimensionada |
Una plataforma sana suele usar varias capas: el HPA escala réplicas; Karpenter aporta nodos si esas réplicas ya no caben; los PDB, topology spread constraints y probes mantienen la disponibilidad mientras cambian los nodos.
Arquitectura interna
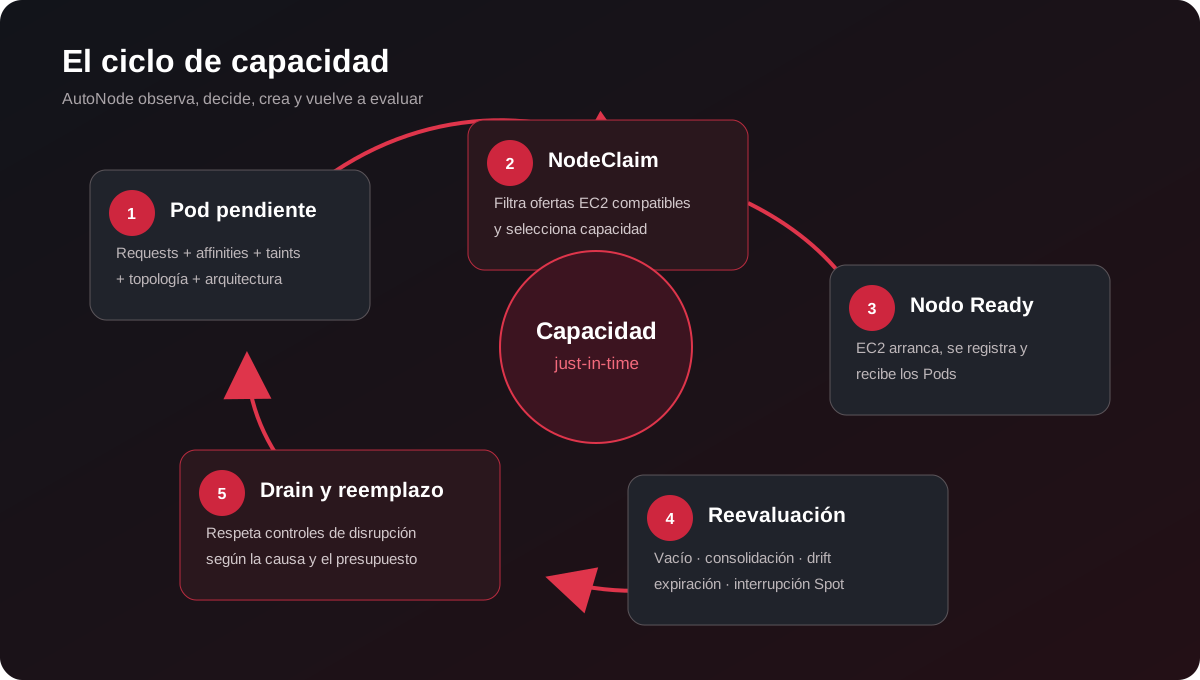
- Una aplicación crea Pods con
resources.requests, selectores, afinidades, tolerations y reglas de topología. - El scheduler intenta ubicarlos. Los que no tienen capacidad compatible quedan
Pending. - El controlador administrado de Karpenter calcula combinaciones de Pods y filtra ofertas EC2 por los requisitos del
NodePooly del Pod. - Crea un
NodeClaim, selecciona tipo, zona y modalidad de capacidad, y llama a EC2 mediante el rol IAM de AutoNode. - La instancia arranca con la imagen de OpenShift aprobada, se registra como Node y recibe los Pods.
- Después, Karpenter evalúa si puede eliminar un nodo vacío, consolidar capacidad, reemplazar un nodo con drift o rotarlo por vencimiento.
Objetos principales
NodePool: expresa restricciones, taints, labels, límites y política de disrupción. Debe diseñarse alrededor de perfiles de carga y tolerancia al riesgo.NodeClaim: representación inmutable de una solicitud concreta de capacidad. Normalmente la crea y elimina Karpenter.OpenshiftEC2NodeClass: recurso de Red Hat para versión de OpenShift, subredes, security groups, EBS, KMS, tags, configuración de kubelet y reservas de capacidad.EC2NodeClass: recurso upstream que ROSA administra detrás deOpenshiftEC2NodeClass. ElNodePoollo referencia congroup: karpenter.k8s.aws.
Karpenter frente a machine pools
| Criterio | Machine pool + Cluster Autoscaler | Red Hat build of Karpenter |
|---|---|---|
| Selección de EC2 | Tipo definido en cada pool | Conjunto flexible de categorías, generaciones, tamaños y zonas |
| Escala inicial | Replica un grupo existente | Crea capacidad a partir de requisitos pendientes |
| Consolidación | Reduce nodos dentro del pool | Puede reemplazar combinaciones ineficientes por otras más adecuadas |
| Previsibilidad | Muy alta | Depende de límites y requisitos declarados |
| Diversidad de instancias | Más trabajo operativo | Es una fortaleza si se mantienen requisitos amplios |
| Spot | Pool específico y configuración adicional | Selección dinámica dentro de las ofertas permitidas |
| Migración | Modelo conocido | Puede coexistir con machine pools para adopción gradual |
| Mejor caso | Carga estable y predecible | Carga variable, diversa o especializada |
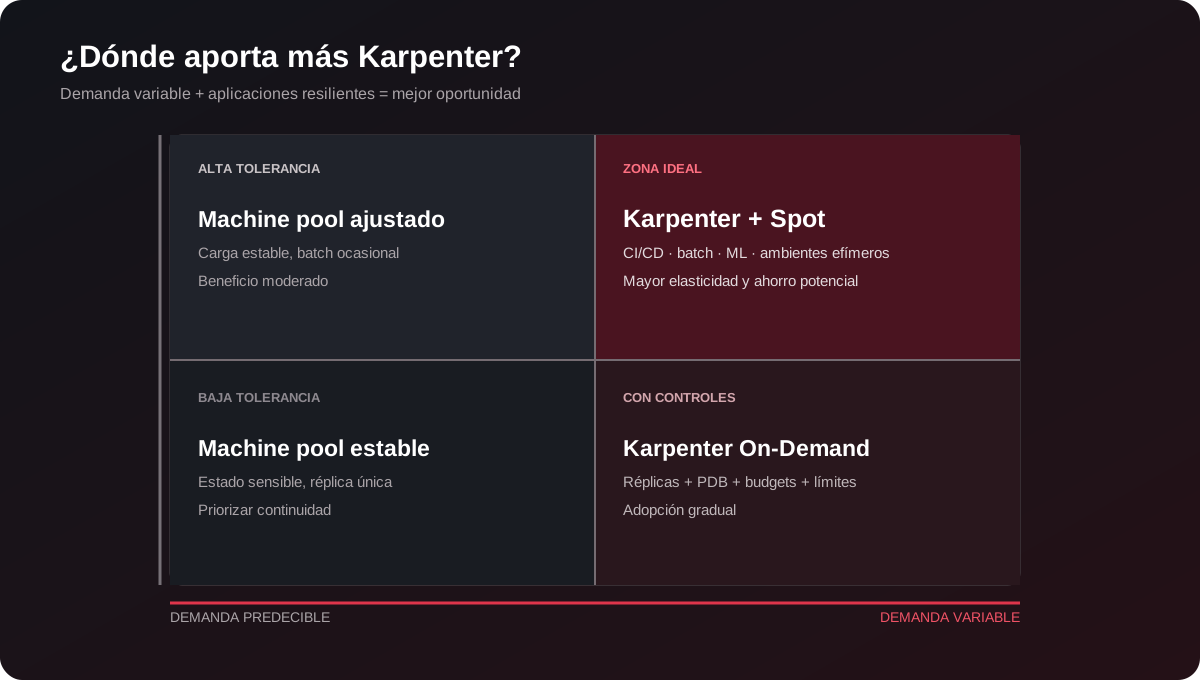
No es necesario eliminar todos los machine pools. Una estrategia madura conserva una base estable para componentes sensibles y mueve primero batch, CI/CD, ambientes efímeros o servicios tolerantes a fallas a NodePools administrados por Karpenter.
Prerrequisitos
- ROSA con Hosted Control Planes en OpenShift 4.22 o posterior.
rosaCLI 1.2.61 o posterior,oc, AWS CLI yjq.- Acceso
cluster-adminy permisos de AWS para crear o asociar roles y policies. - OIDC/STS correctamente configurado para el clúster.
- Cuotas EC2 suficientes por familia, vCPU, Spot, EBS e interfaces de red.
- Subredes privadas con direcciones disponibles y rutas de salida necesarias para que el nodo arranque y se registre.
- Solicitudes de CPU y memoria realistas en todas las cargas que participarán.
- PDB, réplicas, probes y distribución por zona acordes con las disrupciones esperadas.
Configuración de IAM
El controlador necesita un rol que pueda asumir mediante web identity desde el service account system:serviceaccount:kube-system:karpenter. AWS publica la policy administrada ROSAKarpenterControllerPolicy. Según la referencia de policies de ROSA, cubre descubrimiento y creación de recursos EC2, consulta de precios, uso controlado de KMS y paso de roles de worker.
export CLUSTER_NAME="mi-rosa-hcp"
export AWS_REGION="us-east-1"
export CLUSTER_ID="$(rosa describe cluster -c "$CLUSTER_NAME" -o json | jq -r '.id')"
export AWS_ACCOUNT_ID="$(aws sts get-caller-identity --query Account --output text)"
export OIDC_HOST="$(rosa describe cluster -c "$CLUSTER_NAME" -o json \
  | jq -r '.aws.sts.oidc_endpoint_url' | sed 's|https://||')"
La política de confianza debe limitar el sujeto al service account de Karpenter y el proveedor federado al OIDC exacto del clúster:
cat > trust-policy.json <<EOF
{
  "Version": "2012-10-17",
  "Statement": [{
    "Effect": "Allow",
    "Principal": {
      "Federated": "arn:aws:iam::${AWS_ACCOUNT_ID}:oidc-provider/${OIDC_HOST}"
    },
    "Action": "sts:AssumeRoleWithWebIdentity",
    "Condition": {
      "StringEquals": {
        "${OIDC_HOST}:sub": "system:serviceaccount:kube-system:karpenter"
      }
    }
  }]
}
EOF

aws iam create-role \
  --role-name "rosa-karpenter-controller-role-${CLUSTER_NAME}" \
  --assume-role-policy-document file://trust-policy.json \
  --tags Key=red-hat-managed,Value=true

aws iam attach-role-policy \
  --role-name "rosa-karpenter-controller-role-${CLUSTER_NAME}" \
  --policy-arn arn:aws:iam::aws:policy/service-role/ROSAKarpenterControllerPolicy

export KARPENTER_ROLE_ARN="$(aws iam get-role \
  --role-name "rosa-karpenter-controller-role-${CLUSTER_NAME}" \
  --query 'Role.Arn' --output text)"
Antes de habilitar el servicio, revise el trust policy, confirme que no hay comodines innecesarios y registre el rol en infraestructura como código. Los nombres, tags y permisos son parte de la superficie de seguridad, no un paso desechable del laboratorio.
Habilitar AutoNode en un clúster existente
rosa describe cluster -c "$CLUSTER_ID" | grep -i State

rosa edit cluster -c "$CLUSTER_ID" \
  --autonode=enabled \
  --autonode-iam-role-arn="$KARPENTER_ROLE_ARN"
También puede habilitarse en OpenShift Cluster Manager. Para instalaciones reproducibles, el repositorio terraform-rosa de Red Hat Cloud Experts expone karpenter = true para ROSA HCP. Es una automatización de referencia: debe fijarse una versión revisada del módulo, inspeccionar el plan y adaptar red, tags, cifrado y permisos a la organización.
Verificación inicial
oc get crd | grep karpenter
oc get openshiftec2nodeclass
oc get ec2nodeclass
oc get nodepool

# Estado detallado del servicio en ROSA
rosa describe cluster -c "$CLUSTER_ID"
Los recursos default deben reportar READY=True. Es normal que un NodePool recién creado muestre cero nodos: AutoNode crea capacidad cuando existe una demanda que coincide con sus reglas.
Diseñar NodePools para producción
Un NodePool debe representar una frontera operativa: criticidad, arquitectura, modalidad de compra, hardware o equipo propietario. Evite crear un pool por aplicación y evite que todos los Pods coincidan accidentalmente con todos los pools.
Pool base On-Demand para aplicaciones críticas
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: apps-ondemand
spec:
  template:
    metadata:
      labels:
        workload.perzam.com/tier: critical
    spec:
      expireAfter: 720h
      terminationGracePeriod: 30m
      requirements:
        - key: karpenter.k8s.aws/instance-cpu
          operator: Gte
          values: ["4"]
        - key: karpenter.k8s.aws/instance-category
          operator: In
          values: ["c", "m", "r"]
        - key: karpenter.k8s.aws/instance-generation
          operator: Gt
          values: ["5"]
        - key: kubernetes.io/arch
          operator: In
          values: ["amd64"]
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["on-demand"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
  limits:
    cpu: "400"
    memory: 1600Gi
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 10m
    budgets:
      - nodes: "10%"
Este pool permite varias familias, pero excluye Spot. limits reduce el riesgo de un scale-out sin techo; como su evaluación es eventualmente consistente, un crecimiento muy rápido puede superar el límite durante un intervalo corto. El límite de cuenta de AWS sigue siendo una segunda barrera.
Pool Spot aislado para batch y CI
apiVersion: karpenter.sh/v1
kind: NodePool
metadata:
  name: batch-spot
spec:
  weight: 20
  template:
    metadata:
      labels:
        workload.perzam.com/tier: interruptible
    spec:
      taints:
        - key: workload.perzam.com/spot
          value: "true"
          effect: NoSchedule
      requirements:
        - key: karpenter.k8s.aws/instance-cpu
          operator: Gte
          values: ["4"]
        - key: karpenter.k8s.aws/instance-category
          operator: In
          values: ["c", "m", "r"]
        - key: karpenter.k8s.aws/instance-generation
          operator: Gt
          values: ["5"]
        - key: topology.kubernetes.io/zone
          operator: In
          values: ["us-east-1a", "us-east-1b", "us-east-1c"]
        - key: karpenter.sh/capacity-type
          operator: In
          values: ["spot"]
      nodeClassRef:
        group: karpenter.k8s.aws
        kind: EC2NodeClass
        name: default
  limits:
    cpu: "800"
  disruption:
    consolidationPolicy: WhenEmptyOrUnderutilized
    consolidateAfter: 2m
    budgets:
      - nodes: "20%"
La diversidad entre familias, tamaños y zonas mejora la posibilidad de conseguir Spot. EC2 puede recuperar una instancia y normalmente emite un aviso de dos minutos; por eso la aplicación debe tolerar reprogramación, reintentos y pérdida del almacenamiento efímero. La guía oficial de prácticas Spot amplía este modelo.
Personalizar OpenshiftEC2NodeClass
Al habilitar AutoNode se crea una clase default inmutable. Puede referenciarla, pero no editarla. Cree otra clase cuando necesite KMS propio, EBS distinto, tags, subredes, security groups, Capacity Reservations, kubelet tuning o fijar la versión de OpenShift.
apiVersion: karpenter.hypershift.openshift.io/v1
kind: OpenshiftEC2NodeClass
metadata:
  name: apps-encrypted
spec:
  metadataOptions:
    httpTokens: required
  subnetSelectorTerms:
    - tags:
        karpenter.sh/discovery: "<cluster-id>"
        workload-zone: "private"
  securityGroupSelectorTerms:
    - tags:
        karpenter.sh/discovery: "<cluster-id>"
  tags:
    owner: platform
    environment: production
    cost-center: cc-042
  blockDeviceMappings:
    - deviceName: /dev/xvda
      rootVolume: RootVolume
      ebs:
        volumeSizeGiB: 200
        volumeType: GP3
        encrypted: "Encrypted"
        kmsKeyID: "arn:aws:kms:us-east-1:111122223333:key/xxxxxxxx-xxxx-xxxx-xxxx-xxxxxxxxxxxx"
        iops: 3000
        throughput: 125
        deleteOnTermination: Delete
  spec:
    kubelet:
      maxPods: 110
      podsPerCore: 10
      kubeReserved:
        cpu: "500m"
        memory: "1Gi"
      systemReserved:
        cpu: "500m"
        memory: "512Mi"
ROSA exige un volumen raíz mínimo de 100 GiB, cifrado cuando se personaliza, y no admite asociar IP pública a estos workers. IMDSv2 es el valor predeterminado y debe conservarse con httpTokens: required salvo una dependencia antigua plenamente justificada.
No use tags reservados como red-hat-managed, api.openshift.com/* o kubernetes.io/cluster/*. Un cambio en tags, red, storage o versión puede producir drift y reemplazo de nodos. Trate cada modificación como un rollout y revise antes PDB, capacidad y presupuestos de disrupción.
Preparar las aplicaciones
Karpenter decide con la información declarada. Un Pod sin requests no comunica su demanda real; uno sobredimensionado obliga a comprar instancias innecesarias. Antes de medir ahorros, calibre CPU y memoria con métricas históricas y pruebas de carga.
apiVersion: apps/v1
kind: Deployment
metadata:
  name: api-orders
spec:
  replicas: 6
  selector:
    matchLabels:
      app: api-orders
  template:
    metadata:
      labels:
        app: api-orders
    spec:
      nodeSelector:
        workload.perzam.com/tier: critical
      topologySpreadConstraints:
        - maxSkew: 1
          topologyKey: topology.kubernetes.io/zone
          whenUnsatisfiable: DoNotSchedule
          labelSelector:
            matchLabels:
              app: api-orders
      containers:
        - name: api
          image: quay.io/example/orders:1.8.2
          resources:
            requests:
              cpu: "750m"
              memory: 1Gi
            limits:
              cpu: "2"
              memory: 2Gi
          readinessProbe:
            httpGet:
              path: /ready
              port: 8080
            periodSeconds: 5
---
apiVersion: policy/v1
kind: PodDisruptionBudget
metadata:
  name: api-orders
spec:
  minAvailable: 4
  selector:
    matchLabels:
      app: api-orders
Para el pool Spot, el Pod debe añadir el label correspondiente y tolerar el taint. Jobs deben ser idempotentes, guardar checkpoints fuera del nodo y configurar reintentos. Los servicios deben tener múltiples réplicas, distribución entre zonas y tiempos de arranque compatibles con el SLO.
Controles de disrupción
- PDB: protege evicciones voluntarias, pero no evita una interrupción física de Spot.
- NodePool disruption budget: limita cuántos nodos puede reemplazar Karpenter por consolidación, drift o vacío.
expireAfter: la expiración predeterminada es 720 horas. Es una disrupción forzada y no queda bloqueada por el budget del NodePool.terminationGracePeriod: evita drains indefinidos; al vencer puede forzar el borrado de Pods que aún bloqueen la salida.- Topology spread y anti-affinity: reducen el riesgo de concentrar todas las réplicas en un solo nodo o zona.
La documentación upstream de disrupción explica la interacción exacta entre consolidación, drift, expiración, PDB y budgets. Valide siempre qué campos conserva la versión empaquetada por Red Hat.
¿Cuánto puede ahorrar?
No existe un porcentaje universal. El ahorro depende de la variación de la demanda, la exactitud de los requests, la diversidad de ofertas permitidas, el tiempo ocioso actual, el uso de Spot y los compromisos de compra. Una plataforma ya estable, bien empacada y cubierta por Savings Plans puede mostrar poco cambio.
El costo mensual debe incluir al menos:
Costo total aproximado =
  EC2 de worker nodes
  + tarifa ROSA por vCPU de workers
  + tarifa fija de ROSA HCP
  + EBS raíz y volúmenes persistentes
  + balanceadores, NAT Gateway y transferencia
  + observabilidad, logs y snapshots
  - descuentos contractuales / Savings Plans aplicables
La página oficial de precios de ROSA publica las tarifas vigentes. A la fecha de este análisis muestra USD 0,171 por hora por cada 4 vCPU de workers bajo demanda y USD 0,25 por hora por clúster HCP, antes de descuentos y del consumo de infraestructura. Esos valores cambian y deben consultarse antes de elaborar un caso financiero.
Cómo medir el beneficio de forma seria
- Capture cuatro semanas de costo EC2, vCPU-hora de ROSA, utilización y Pods pendientes.
- Separe costos por ambiente, equipo, modalidad de compra y familia mediante tags.
- Seleccione una carga variable con buen control de requests.
- Ejecute un piloto de dos semanas, incluido al menos un pico real.
- Compare costo por unidad útil: build terminado, transacción, lote procesado o hora de GPU, no solo factura total.
- Incluya el costo de interrupciones, tiempos de arranque y horas operativas.
Observabilidad y operación diaria
# Recursos de Karpenter
oc get nodepool,nodeclaim,ec2nodeclass,openshiftec2nodeclass

# Estado y eventos
oc describe nodepool apps-ondemand
oc describe nodeclaim <nombre>
oc get events -A --sort-by=.lastTimestamp | tail -100

# Inventario con procedencia, tipo, zona y modalidad
oc get nodes -L karpenter.sh/nodepool,node.kubernetes.io/instance-type,\
topology.kubernetes.io/zone,karpenter.sh/capacity-type

# Consumo y límites declarados por NodePool
oc get nodepool -o json \
  | jq '.items[] | {name:.metadata.name, limits:.spec.limits, usage:.status.resources}'

# Pods que siguen pendientes
oc get pods -A --field-selector=status.phase=Pending -o wide
Supervise latencia de aprovisionamiento, tasa de NodeClaims fallidos, Pods pendientes, capacidad por modalidad, interrupciones, consolidaciones, errores IAM, uso de cuota y porcentaje de nodos no listos. Karpenter expone métricas Prometheus; varias métricas internas son alfa, por lo que los dashboards deben versionarse junto con el componente. Consulte la referencia de métricas.
En ROSA HCP el controlador no aparecerá como un Pod normal en los workers. Red Hat administra esa capa. Si requiere diagnóstico profundo, habilite y exporte logs del hosted control plane hacia el destino corporativo aprobado, por ejemplo CloudWatch o S3, y correlacione con CloudTrail para llamadas de EC2 e IAM.
Fallas comunes y cómo leerlas
| Síntoma | Causa probable | Comprobación |
|---|---|---|
| No aparecen CRD | AutoNode no terminó de habilitarse o el rol no quedó asociado | Espere unos minutos, revise rosa describe cluster y el estado del servicio |
EC2NodeClass no está Ready | Tags de descubrimiento faltantes en subred o security group | Compare karpenter.sh/discovery con el ID exacto del clúster |
UnauthorizedOperation | Policy ausente, trust OIDC incorrecto o falta iam:PassRole | Revise CloudTrail, policies adjuntas y condición sub |
| Pods siguen Pending | Requests incompatibles, taint sin toleration, selector imposible o falta cuota | oc describe pod, eventos del NodePool y Service Quotas |
| No hay capacidad Spot | Oferta demasiado restringida por familia, tamaño o zona | Amplíe categorías y zonas o añada un pool On-Demand de respaldo explícito |
| Nodos no consolidan | PDB, Pods no desalojables, almacenamiento local o reglas de topología | Inspeccione Pods por nodo y motivos de disrupción |
| Escala más de lo esperado | Requests altos, DaemonSets costosos o límites eventualmente consistentes | Compare requests agregados, overhead de DaemonSets y status.resources |
| Rollout inesperado | Drift por cambio de NodeClass, versión o AMI | Revise condiciones del NodeClaim y cambios GitOps recientes |
Red Hat mantiene una sección específica de troubleshooting para CRD ausentes, descubrimiento de red y errores de tags/IAM.
Seguridad y gobierno
- Least privilege: use la policy administrada para la integración y una trust policy restringida al OIDC y service account del clúster.
- IMDSv2: mantenga tokens requeridos. No rebaje a IMDSv1 para solucionar una aplicación antigua sin un plan de retiro.
- Workers privados: los nodos no necesitan IP pública. Controle egress mediante las rutas y servicios de red aprobados.
- Cifrado: use EBS cifrado; si exige CMK, añada al key policy el rol de AutoNode y administre rotación y grants.
- Admission policy: valide requests, límites, PDB, labels corporativos y repositorios de imágenes antes de permitir workloads en pools elásticos.
- Cost controls: combine límites de NodePool, cuotas AWS, presupuestos, tags obligatorios y alertas de anomalías.
- Change control: administre NodePools y NodeClasses mediante GitOps. Los cambios pueden reemplazar infraestructura.
Actualizaciones y ciclo de vida
La clase default sigue la versión del hosted control plane y sus nodos se actualizan con ese ciclo. Una OpenshiftEC2NodeClass personalizada sin spec.version también sigue el control plane. Si se fija una versión, Red Hat admite una diferencia limitada respecto al control plane; no debe usarse como mecanismo para congelar indefinidamente workers antiguos.
La guía de actualización de ROSA explica el orden: primero el hosted control plane y luego los machine pools o NodeClasses que se administren por separado. Antes de cada cambio:
- Revise disponibilidad de la versión y skew permitido.
- Confirme PDB, réplicas y capacidad de reemplazo.
- Reduzca consolidaciones voluntarias durante la ventana si compiten con el rollout.
- Observe NodeClaims, Nodes, Pods pendientes y SLO durante el reemplazo.
- Quite el pin una vez validada la versión, si el objetivo es volver al ciclo administrado.
Plan de adopción recomendado
- Clasificar: separe cargas críticas, elásticas, batch, GPU y estado persistente.
- Corregir requests: sin esta base, Karpenter optimiza datos equivocados.
- Crear un pool On-Demand: úselo como primer piloto con límites bajos y una aplicación no crítica.
- Añadir aislamiento: labels, taints y tolerations hacen explícita la ubicación.
- Medir: aprovisionamiento, utilización, costo por unidad y disrupciones.
- Probar Spot: solo para cargas tolerantes, con diversidad de zonas e instancias.
- Activar consolidación: empiece con tiempos conservadores y budgets bajos.
- Automatizar: mueva NodePools, NodeClasses, alertas y dashboards a GitOps.
- Expandir por perfil: migre equipos y casos de uso, no toda la plataforma en una sola ventana.
Matriz de decisión
| Escenario | Recomendación | Razón |
|---|---|---|
| Microservicios con picos y réplicas distribuidas | Sí | Right-sizing y scale-out sin mantener muchos pools |
| CI/CD, Jobs y procesamiento batch idempotente | Sí, ideal con Spot | Alta elasticidad y buena tolerancia a interrupciones |
| GPU o ML con demanda intermitente | Sí, con reservas y límites | Evita mantener hardware costoso ocioso |
| Aplicación estable 24/7 y tamaño conocido | Beneficio limitado | Un machine pool ajustado puede ser más simple |
| Base de datos sensible, réplica única y storage local | No al inicio | La disrupción y consolidación elevan el riesgo |
| Pods sin requests, PDB ni probes | No todavía | Primero debe madurar la disciplina de plataforma |
| ROSA Classic | No disponible como integración administrada | AutoNode está dirigido a ROSA HCP |
Prueba técnica mínima
Después de crear un NodePool de laboratorio, provoque una demanda que no quepa en los nodos actuales y observe el ciclo completo:
oc create namespace karpenter-lab

oc -n karpenter-lab create deployment inflate \
  --image=registry.k8s.io/pause:3.10 --replicas=0

oc -n karpenter-lab set resources deployment/inflate \
  --requests=cpu=1,memory=1Gi

oc -n karpenter-lab patch deployment inflate --type merge -p '
spec:
  template:
    spec:
      nodeSelector:
        workload.perzam.com/tier: critical'

oc -n karpenter-lab scale deployment inflate --replicas=10

watch 'oc get pods -n karpenter-lab -o wide; echo; \
oc get nodeclaim; echo; \
oc get nodes -L karpenter.sh/nodepool,node.kubernetes.io/instance-type,karpenter.sh/capacity-type'

# Limpieza: permite observar la consolidación
oc delete namespace karpenter-lab
Una prueba completa registra el tiempo desde Pending hasta Running, el tipo elegido, la zona, la modalidad de compra, el bin-packing, la eliminación posterior y cualquier evento de fallo. No use un clúster productivo para experimentar con límites o políticas de interrupción sin una ventana y un alcance controlado.
Conclusión
Karpenter sí tiene sentido en ROSA HCP cuando la plataforma necesita elasticidad real y variedad de cómputo. Reduce el trabajo de mantener numerosos machine pools, mejora el ajuste entre Pods e instancias y abre una ruta más natural a Spot, reservas de capacidad y aceleradores.
El resultado depende del diseño. Hay que declarar requests honestos, separar cargas por tolerancia a fallas, fijar On-Demand donde corresponda, imponer límites, probar interrupciones y entender que la consolidación reemplaza nodos. La recomendación para una empresa es adoptarlo de forma gradual: base estable con machine pools, primer NodePool On-Demand, piloto medido, luego Spot y perfiles especializados.
Si el entorno es pequeño y predecible, la simplicidad de un machine pool bien dimensionado puede valer más que la optimización dinámica. Si la plataforma es grande, variable y heterogénea, AutoNode puede convertirse en una pieza central de FinOps y operación de OpenShift.
Documentación para ampliar
- Red Hat: administrar nodos con Red Hat build of Karpenter
- Red Hat Cloud Experts: laboratorio de AutoNode en ROSA HCP
- Red Hat: presentación y prácticas recomendadas
- Red Hat: troubleshooting de ROSA y Karpenter
- AWS: policies administradas para ROSA
- Karpenter: referencia de NodePools
- Karpenter: consolidación y disrupciones
- AWS: prácticas recomendadas para EC2 Spot
- AWS: precios actuales de ROSA